타임아웃과 재시도 정책 — 기획자도 정해야 하는 실패 대응
네트워크는 언젠가 반드시 실패합니다. 응답이 없을 때 얼마나 기다리고(타임아웃), 몇 번 다시 시도할지(재시도)를 정하지 않으면 서비스는 멈추거나 사고를 냅니다. 재시도 정책이 왜 개발만의 문제가 아니라 기획의 결정인지, 코드 없이 정리했습니다.
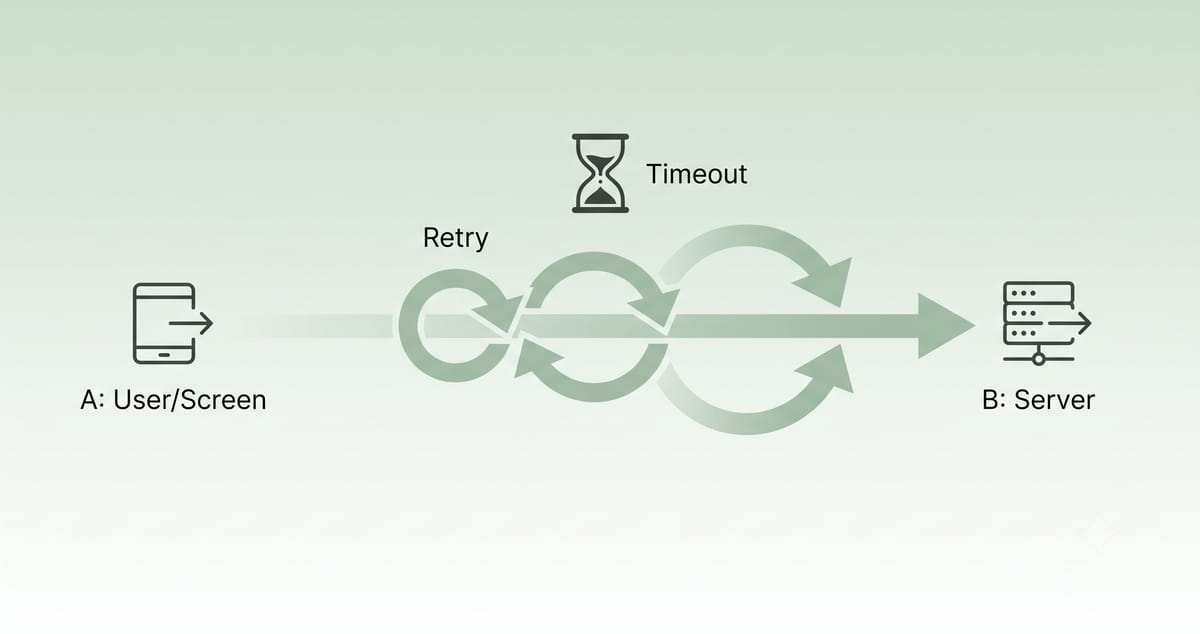
네트워크는 언젠가 반드시 실패한다
버튼을 눌렀는데 화면이 한참 멈춰 있던 경험, 누구나 있습니다. 서버가 느리거나, 잠깐 끊기거나, 응답이 오다 말거나 — 이런 일은 예외가 아니라 정상적으로 늘 일어나는 일입니다. 인터넷을 거치는 모든 요청은 언젠가 반드시 실패합니다. 문제는 "실패하느냐"가 아니라 "실패했을 때 어떻게 하느냐"이고, 그 대응을 미리 정해 둔 것이 바로 재시도 정책입니다.
이 정책의 두 축이 타임아웃(언제까지 기다릴지)과 재시도(몇 번 다시 시도할지)입니다. 그리고 재시도 정책은 개발자만의 기술 선택이 아닙니다. "사용자를 얼마나 기다리게 할지", "실패하면 무엇을 보여줄지"를 정하는 일이라, 본질적으로 기획의 결정입니다. 이 글은 코드를 몰라도 되는 선에서 그 판단 기준을 정리합니다.
타임아웃 — 언제까지 기다릴 것인가
타임아웃은 "이만큼 기다려도 응답이 없으면 실패로 간주한다"는 제한 시간입니다. 왜 필요할까요. 응답을 무한정 기다리면, 사용자는 멈춘 화면을 하염없이 보고 있어야 하고, 서버는 끝나지 않는 요청을 붙들고 있다가 자원이 바닥납니다. 한 요청이 안 끝나서 뒤따르는 요청까지 줄줄이 막히는 것이죠.
그래서 "몇 초까지만 기다린다"는 선을 그어야 합니다. 이 선을 너무 짧게 잡으면 멀쩡한 요청도 실패로 처리되고, 너무 길게 잡으면 사용자가 지칩니다. 적절한 타임아웃 값은 기술이 아니라 사용자 경험의 문제입니다 — "이 화면에서 사용자는 몇 초까지 기다려 줄까?"
재시도 — 실패하면 다시, 그러나 신중하게
타임아웃으로 실패를 감지했다면, 다음 선택은 재시도입니다. 일시적인 문제(잠깐의 네트워크 끊김 같은)는 다시 시도하면 대개 성공합니다. 그래서 재시도는 강력한 도구입니다. 하지만 무작정 재시도는 위험합니다. 실패한 서버에 재시도가 몰리면, 가뜩이나 힘든 서버를 아예 쓰러뜨릴 수 있습니다.
재시도 정책, 무엇을 정해야 하나
좋은 재시도 정책은 세 가지를 정해 둡니다.
몇 번까지 다시 시도할지
무한 재시도는 금물입니다. 보통 2~3회 선에서 멈추고, 그래도 안 되면 실패를 인정하고 사용자에게 알립니다. "될 때까지"는 정책이 아니라 사고입니다.
얼마 간격으로 다시 시도할지
실패하자마자 곧바로, 그것도 여러 번 몰아서 재시도하면 서버에 부담이 쌓입니다. 그래서 재시도 간격을 점점 넓히는 방식을 씁니다 — 1초 뒤, 안 되면 2초 뒤, 그래도 안 되면 4초 뒤. 이렇게 간격을 늘려 가면 힘든 서버에 숨 쉴 틈을 주면서 회복을 기다릴 수 있습니다. (이 방식을 '지수 백오프'라고 부르지만, 기획자는 "간격을 점점 넓힌다"만 알면 충분합니다.)
무엇을 재시도하면 안 되는가
가장 중요한 항목입니다. 조회는 몇 번을 다시 해도 안전하지만, 결제·주문 같은 실행은 재시도가 곧 중복 위험입니다. "결제 요청이 성공했는데 응답만 못 받은" 상황에서 재시도하면, 같은 결제가 두 번 일어날 수 있습니다. 그래서 이런 작업은 멱등성(idempotency)이라는 안전장치와 반드시 함께 설계해야 합니다 — 같은 요청이 여러 번 와도 결과는 한 번만 반영되도록.
재시도가 위험할 때 — 재시도 폭풍
재시도의 대표적인 사고가 '재시도 폭풍(retry storm)'입니다. 서버가 잠깐 느려지자, 수많은 클라이언트가 동시에 "실패했네, 다시!" 하고 재시도를 퍼붓습니다. 원래는 잠깐 쉬면 회복될 서버가, 몰려드는 재시도에 완전히 무너집니다. 실패를 수습하려던 재시도가 오히려 장애를 키우는 것이죠.
그래서 재시도는 "간격을 넓히고, 횟수를 제한하고, 안 되면 깔끔하게 포기하는" 절제가 핵심입니다. 재시도를 다 소진해도 실패하면, 그때는 폴백(fallback)이라는 대안으로 넘어갑니다 — 캐시된 옛 데이터라도 보여주거나, "잠시 후 다시 시도해 주세요" 안내를 띄우거나.
기획자·PM이 정해야 할 것
재시도 정책의 기술적 구현은 개발자 몫이지만, 그 기준은 기획이 정합니다.
- 얼마나 기다리게 할지: 이 화면에서 사용자가 참아 줄 시간은 몇 초인가. 그 안에 로딩 표시를 어떻게 보여줄지도 함께.
- 실패하면 무엇을 보여줄지: 재시도가 다 실패했을 때의 화면 문구. "오류가 발생했습니다"보다 "네트워크가 불안정합니다. 다시 시도해 주세요"가 낫습니다.
- 무엇을 재시도하면 안 되는지: 결제·주문·전송처럼 중복되면 안 되는 동작을 목록으로 짚어 개발팀과 공유.
실패는 예외가 아니라 기본값이다
재시도 정책의 핵심을 한 줄로 줄이면 이렇습니다. 실패는 어쩌다 일어나는 예외가 아니라, 늘 일어나는 기본값입니다. 그러니 "잘 되면 어떻게"가 아니라 "안 될 때 어떻게"를 미리 정해 두는 것이 서비스의 완성도를 가릅니다.
그리고 그 정해 두는 일의 절반은 기획의 몫입니다 — 얼마나 기다리게 할지, 몇 번 다시 해볼지, 무엇은 절대 다시 하면 안 되는지, 끝내 실패하면 무엇을 보여줄지. 이건 캐시나 폴백처럼, 눈에 잘 안 보이지만 사용자가 서비스를 신뢰하게 만드는 결정입니다. 다음에 "이 기능 만들어 주세요"라고 요청할 때, "그런데 실패하면요?"를 한 문장 덧붙여 보세요.