온디바이스 AI에서 하이브리드 AI로 — 라우팅이 만드는 다음 1~2년
온디바이스 AI가 지금 IT 화두로 떠오른 이유부터 짚고, 결국 하이브리드 AI로 향하는 흐름을 정리했습니다. 라우팅 4가지, 실제 적용 사례, 앞으로 챙겨야 할 설계 포인트를 기획자·개발자 시선으로 다뤘습니다.
온디바이스 AI가 지금 화두가 된 이유
온디바이스 AI(On-Device AI)는 말 그대로 스마트폰·노트북·자동차 같은 단말 안에서 AI 모델을 직접 돌리는 방식입니다. 클라우드 서버에 데이터를 보내지 않고, 내 디바이스 안의 NPU(신경처리장치)가 모델 연산을 끝냅니다. 결과가 빠르고, 데이터가 밖으로 안 나가고, 인터넷이 끊겨도 동작합니다.
이 단어가 최근 IT 뉴스의 단골이 된 이유는 크게 세 가지입니다.
첫째, 클라우드 LLM의 부담이 한계에 닿았습니다. 호출할 때마다 API 비용이 쌓이고, 네트워크 지연이 붙고, 무엇보다 사용자 데이터가 외부 서버로 나갑니다. Claude Opus 4.8 정리 글에서 봤듯이 클라우드 측 모델 자체는 무섭게 좋아지지만, 그만큼 호출 비용과 프라이버시 부담도 같이 커지는 구조입니다. 한 사용자당 하루 수십 번씩 AI를 부르는 시대로 가면 이 부담은 빠르게 무거워집니다.
둘째, NPU 하드웨어가 자리잡았습니다. 애플의 Neural Engine은 M·A 시리즈 칩에 들어간 지 오래고, 퀄컴 Snapdragon X Elite, 인텔 Core Ultra 같은 PC용 칩이 본격적으로 NPU를 탑재하기 시작했습니다. 마이크로소프트의 'Copilot+ PC' 카테고리도 NPU 성능을 전제로 만들어진 흐름입니다. 디바이스가 모델을 돌릴 수 있는 물리적 기반이 마련된 것입니다.
셋째, 소형 언어 모델(SLM, Small Language Model)의 성능이 빠르게 올라왔습니다. 구글 젬마(Gemma), MS 파이(Phi), 메타 Llama 3.2의 1B·3B 같은 모델은 수십억 파라미터 규모로 노트북·스마트폰 안에서 돌아갑니다. 1~2년 전만 해도 클라우드만 풀 수 있던 작업의 상당 부분을 이제 디바이스가 풀어냅니다.
여기까지가 온디바이스 AI가 지금 화두인 이유입니다. 그런데 이 흐름이 향하는 종착지가 따로 있는데, 그게 바로 하이브리드 AI입니다.
노트북·폰 어디에나 들어가지만, 결국 하이브리드로 향한다
온디바이스 AI는 사실상 모든 단말 카테고리에 들어오는 중입니다. 스마트폰 쪽은 애플 인텔리전스(Apple Intelligence)와 갤럭시 AI가 NPU 위에서 음성 비서·번역·사진 편집을 처리합니다. 노트북 쪽은 Copilot+ PC, Apple M 시리즈 맥북, 인텔 AI PC가 같은 방향을 가고 있습니다. 자동차에는 ADAS와 인포테인먼트 영역에 엣지 AI가 이미 들어가 있습니다.
그런데 흥미로운 점은 이 단말들이 전부 순수 온디바이스로 가지는 않는다는 것입니다. 실제 출시되는 제품은 거의 예외 없이 하이브리드 구조입니다. 이유는 명확합니다.
- SLM은 빠르고 안전하지만 작습니다. 수천억 단위 파라미터의 LLM이 풀어내는 복잡한 추론, 최신 정보 검색, 멀티 에이전트 워크플로우 같은 작업을 단독으로 풀기는 어렵습니다.
- 사용자의 기대치는 이미 클라우드 LLM에 맞춰져 있습니다. "ChatGPT만큼은 해줘야 한다"는 기대 위에서 디바이스만으로 풀려고 하면 답답함이 남습니다.
- 반대로 모든 작업을 클라우드로 보내면 비용·지연·프라이버시가 다시 무거워집니다. 온디바이스로 옮긴 보람이 사라집니다.
결국 어느 한쪽으로는 갈 수 없습니다. 두 영역의 장점만 골라 쓰는 구조 — 빠르고 안전한 일은 디바이스가, 무겁고 복잡한 일은 클라우드가 맡는 분업 — 이 자연스러운 답이 됩니다. 이 분업의 이름이 하이브리드 AI입니다.
하이브리드 AI를 움직이는 4가지 라우팅
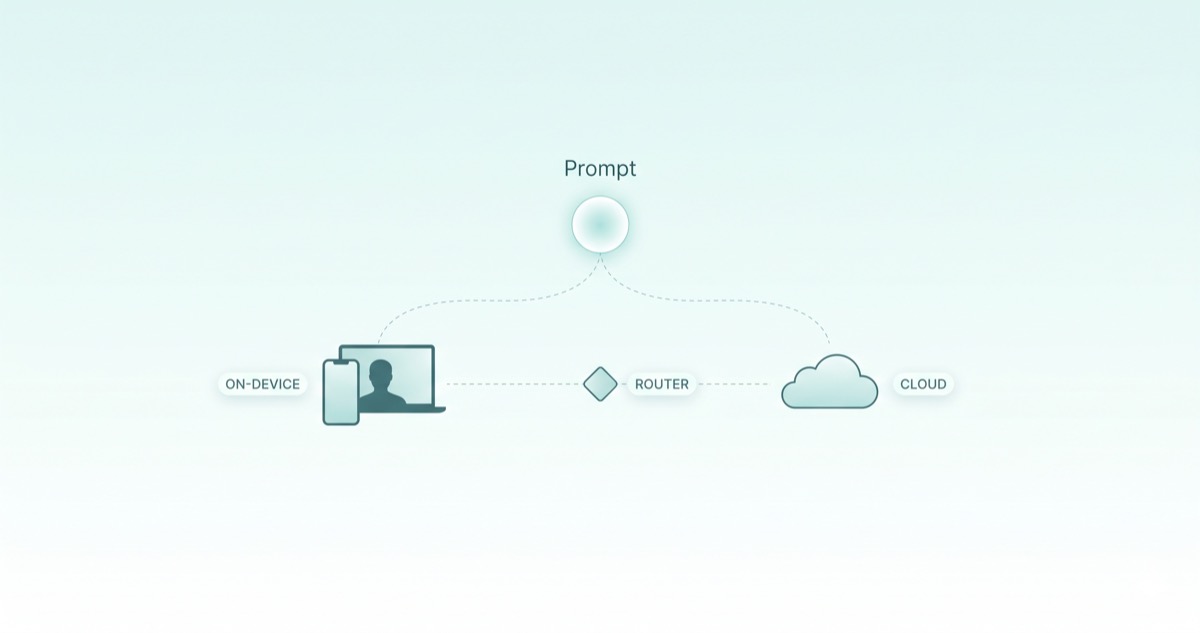
하이브리드 AI의 본질은 모델 자체가 아니라 라우팅 정책입니다. 사용자의 명령(Prompt)이 들어오면 디바이스 안의 'AI 오케스트레이터(Orchestrator)' 소프트웨어가 작업의 성격을 판단해, 디바이스 안에서 끝낼지 클라우드로 보낼지 그 자리에서 결정합니다. 판단 기준은 보통 네 가지로 정리됩니다.
1. 보안 기반 라우팅 (Privacy-First Routing)
입력된 데이터에 주민등록번호·계좌번호·여권번호 같은 개인정보(PII)나 회사 기밀이 포함되어 있는지를 로컬에서 먼저 스캔합니다. 해당되면 5G 신호가 아무리 좋아도 클라우드로 전송하지 않고 무조건 온디바이스 NPU에서 처리합니다. 기획자 시선에서 중요한 점은 "민감 정보의 정의"가 결국 제품 정책 결정이라는 사실입니다. 이 경계가 흐릿하면 라우팅도 흐릿해집니다.
2. 컨텍스트 크기 라우팅 (Context-Size Routing)
"이메일 맞춤법 봐줘" 같은 가벼운 요청은 디바이스의 경량 모델로 1초 안에 끝납니다. 반면 "지난 1년 치 보고서 50장을 요약해줘"처럼 수만 토큰을 다루거나 복잡한 다단계 추론이 필요한 작업은 데이터센터의 LLM으로 작업을 완전히 이관(Offloading)합니다. 개발자 입장에서 이 라우팅은 토큰 카운팅의 부활이기도 합니다. 입력 토큰 길이나 작업의 깊이를 기준으로 1차 분기하는 로직이 클라이언트 레벨에 들어옵니다.
3. 네트워크·비용 라우팅 (Cost & Connectivity Routing)
오프라인이나 비행기 모드일 때는 강제로 모든 연산이 온디바이스로 처리됩니다. 온라인 상태에서는 빅테크 기업이 자사의 API 호출 비용을 줄이기 위해 먼저 로컬에서 풀어보고, 신뢰도(Confidence Score)가 한계치를 넘을 때만 클라우드 버스팅(Cloud Bursting)을 합니다. 비용은 사용자에게도 영향을 줍니다. 같은 기능을 무료 티어에서는 디바이스 처리까지만, 유료 티어에서는 클라우드 처리까지 풀어주는 차등 구조가 자연스러운 흐름입니다.
4. 하이브리드 RAG — 결과 합성
가장 흥미로운 라우팅입니다. "내 스마트폰에 저장된 사진 중 어제 뉴스에 나온 장소와 비슷한 곳을 찾아줘" 같은 요청이 들어오면 한쪽이 단독으로는 풀 수 없습니다. 클라우드 AI가 최신 뉴스 데이터를 검색해 장소 정보를 디바이스로 내려보내고, 온디바이스 AI가 로컬 사진 갤러리를 뒤져 매칭 결과를 합쳐 보여줍니다. 두 모델이 한 쿼리 안에서 협업하는 구조입니다.
하이브리드가 실제로 풀어내는 문제들
라우팅 4종은 이미 상용 제품 안에서 작동하고 있습니다. 세 가지 영역만 짧게 봅니다.
스마트폰 카메라·갤러리
애플 인텔리전스와 갤럭시 AI가 거의 같은 패턴을 씁니다. 카메라 셔터를 누르는 순간의 피사체 인식, 피부 톤 보정, 사진 속 텍스트 실시간 인식은 지연이 허용되지 않아 디바이스 안에서 처리됩니다. 반면 사진 속 인물을 자연스럽게 지우고 빈 자리를 채워 넣는 생성형 편집(Generative Edit), "작년 가을 제주도에서 먹었던 고기국수 사진 찾아줘" 같은 시맨틱 검색은 대용량 멀티모달 연산이 필요하니 클라우드로 데이터를 올려 처리합니다.
실시간 음성 비서·동시통역
음성을 텍스트로 바꾸는 STT, "엄마한테 전화해 줘"·"알람 꺼 줘" 같은 기본 명령, 오프라인 1:1 단순 번역은 디바이스 안에서 즉시 실행됩니다. 답답함을 없애는 영역입니다. 반대로 "거래처 메일 어조가 딱딱한데 부드럽게 답장 프레임 짜고 비행기 표 예약 일정이랑 연동해 줘" 같은 복합 명령은 서드파티 API 연동과 비즈니스 맥락 판단이 필요하니 클라우드가 전담합니다. 최근 Gemini Spark 같은 에이전트형 AI가 자리잡는 영역도 결국 여기입니다.
자율주행·커넥티드 카
전방 차량 급제동 감지, 차선 이탈 방지, 보행자 인식 같은 안전 직결 제어 로직은 차량 안의 엣지(Edge) 컴퓨터가 단독 처리합니다. 터널이나 음영 지역에서 인터넷이 끊겨도 오작동하면 안 되기 때문입니다. 반면 실시간 교통량 변화에 따른 우회 경로 재탐색, 인포테인먼트의 맛집 추천 대화, OTA 소프트웨어 업데이트 최적화는 클라우드 서버와 통신하며 백그라운드에서 여유롭게 연산합니다.
앞으로 하이브리드 AI는 어디에 관심을 두어야 할까
전망 한 가지는 분명합니다. 라우팅 경계는 매년 다시 그어집니다. 디바이스 측 모델의 능력이 빠르게 올라오면서, 작년에 클라우드로 보냈던 작업이 올해는 디바이스에서 끝납니다. 반대로 클라우드 측은 컨텍스트 윈도가 100만 토큰을 넘어가고, 멀티 에이전트·툴 사용 같은 복합 워크플로우가 그쪽에만 가능한 영역으로 자리잡습니다. 두 영역이 각각 깊어지면서 그 사이의 라우팅 정책이 더 정교해지는 방향입니다.
그래서 앞으로 1~2년 동안 하이브리드 AI를 다루는 기획자·개발자가 관심을 두어야 할 지점은 다음과 같이 정리됩니다.
| 관심 지점 | 핵심 질문 |
|---|---|
| 라우팅 정책 | 어떤 작업을 디바이스에 두고, 어떤 작업을 클라우드로 보낼 것인가 |
| 민감 정보의 경계 | 어디까지가 디바이스 안에만 두어야 할 데이터인가 |
| 응답 시간 분기 | 100ms와 3초가 같은 함수에서 나올 때 UI를 어떻게 설계할 것인가 |
| 오프라인 폴백 | 디바이스만 살아 있을 때 어떤 기능이 축소되어 동작하는가 |
| 비용 차등 구조 | 무료·유료 티어 사이의 라우팅 차이를 어떻게 둘 것인가 |
특히 라우팅 정책은 OS·플랫폼이 1차 결정자라는 점이 중요합니다. 애플 인텔리전스의 라우팅은 앱이 통제할 수 없고, 갤럭시 AI도 비슷합니다. 앱 개발자는 디바이스 측 SDK를 호출할 뿐, 같은 호출이 디바이스에서 끝날지 클라우드로 넘어갈지 직접 정하지 못하는 경우가 많습니다. 그래서 두 가지 응답 시간을 모두 가정한 UI 설계가 사실상 필수입니다.
기획자가 결정해야 할 큰 한 가지는 민감 정보의 경계입니다. 이게 흐릿하면 라우팅 정책도 흐릿해지고, 결국 제품의 신뢰도에 균열이 생깁니다.
영리한 교통정리가 곧 경쟁력이다
온디바이스 AI가 지금 화두로 떠오른 이유 — 비용·지연·프라이버시 — 는 사실 클라우드 LLM의 한계에서 출발한 것이고, 그 한계를 풀기 위해 디바이스만으로 가다 보면 또 다른 한계에 닿습니다. 두 영역을 같이 다루는 하이브리드 AI는 그 사이를 영리하게 가르는 답입니다.
하이브리드 AI의 본질은 모델이 아니라 두 영역 사이의 라우팅 정책에 있습니다. UX의 즉각성과 프라이버시는 디바이스에 맡기고, 무한한 지식베이스와 고성능 추론은 클라우드에 아웃소싱하는 영리한 교통정리에 가깝습니다.
사용자에게는 한 가지 경험으로 보이되, 내부에서는 여러 모델이 한 쿼리 안에서 협업하는 구조. 앞으로 1~2년 동안 거의 모든 AI 제품이 이 방향으로 수렴해갈 가능성이 큽니다.